Brevet Generation Super Sampling : comment l’IA de Sony lit les sticks de la DualSense pour prédire l’image suivante sans latence
Le talon d’Achille historique de la génération d’images par intelligence artificielle tient en deux mots : la latence d’entrée. Alors que les technologies d’interpolation actuelles obligent la carte graphique à mettre en attente une image déjà calculée pour fabriquer une frame intermédiaire, Sony Interactive Entertainment (SIE) vient de publier un brevet d’architecture neuronale radicalement différent. Intitulé « Generation Super Sampling » et enregistré auprès de l’office américain des brevets (USPTO) sous la référence US 2026/0320740 A1 en date du 15 octobre 2026, ce document signé par l’ingénieur Denis Dupeyron détaille un système capable de prédire l’image suivante en lisant directement les commandes de la manette en temps réel.
De l’interpolation passive à l’extrapolation prédictive : la rupture architecturale de Denis Dupeyron
Pour mesurer la portée scientifique du brevet US 2026/0320740 A1, il faut d’abord comprendre pourquoi la Frame Generation classique divise autant les joueurs exigeants. Qu’il s’agisse du DLSS 3 de NVIDIA ou du FSR 3 d’AMD, le pipeline repose sur l’interpolation : le processeur graphique (GPU) calcule l’image N, puis calcule l’image N+1, mais au lieu d’afficher immédiatement cette dernière à l’écran, le moteur la retient en mémoire tampon pour synthétiser une image N+0,5 intercalée entre les deux. Si la fluidité visuelle double à l’œil nu, le délai entre l’action du joueur sur ses sticks et la réponse à l’écran s’alourdit mécaniquement.
L’approche conçue par Denis Dupeyron chez Sony Interactive Entertainment inverse totalement cette logique temporelle en basculant vers l’extrapolation prédictive. Au lieu d’attendre que le GPU ait terminé le rendu de la deuxième image réelle, le système s’appuie sur une seule image fraîchement calculée pour générer et afficher immédiatement la frame suivante à l’écran, pendant que le processeur graphique poursuit en arrière-plan le calcul de la prochaine image native. Ce pipeline s’inscrit dans le prolongement direct du déploiement de l’upscaling IA QSSR et du PSSR sur l’écosystème PlayStation 5, tout en s’attaquant cette fois au verrou de la réactivité.
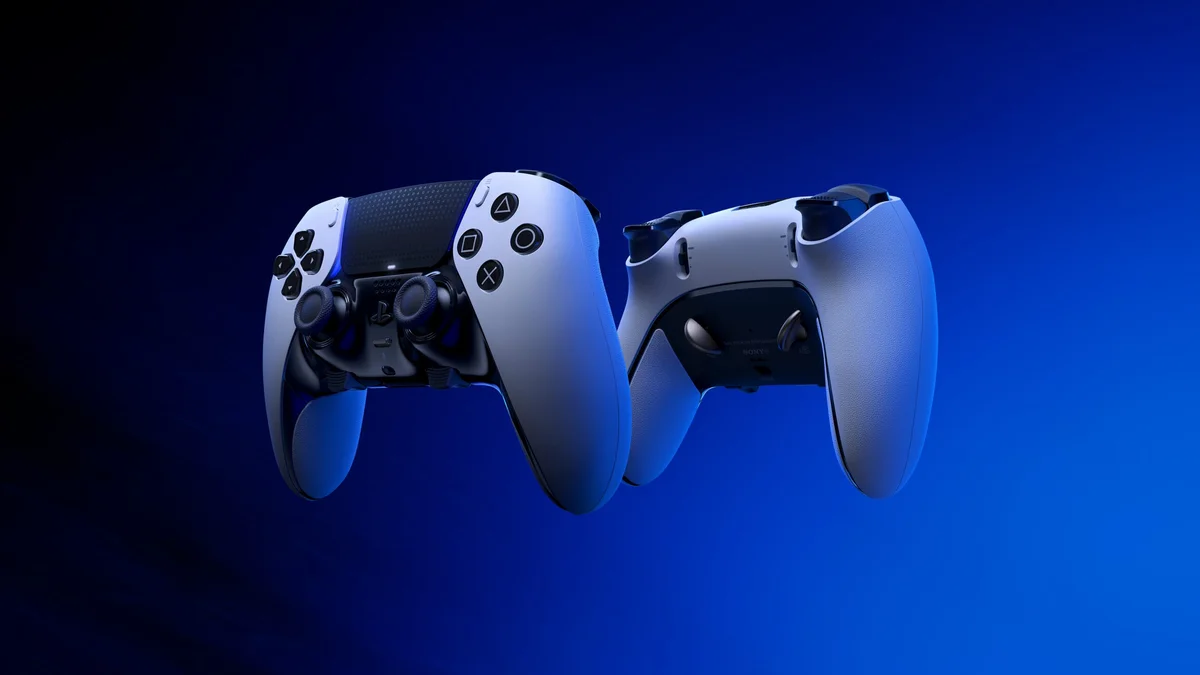
Comment les sticks et gâchettes de la DualSense guident le réseau neuronal Encodeur-Décodeur
Dans la littérature du Deep Learning appliqué au rendu temps réel, l’extrapolation pure s’est longtemps heurtée à un obstacle majeur : dès que le joueur donne un coup de stick brusque pour faire pivoter la caméra à 180 degrés ou déclenche un tir réflexe, un modèle qui ne regarde que les images passées devine mal la trajectoire future et produit des artefacts visuels (ghosting ou déformations géométriques sur les bords de l’écran).
C’est précisément là que réside l’innovation centrale du brevet Generation Super Sampling. L’architecture décrite par Sony repose sur un réseau neuronal scindé en deux étages complémentaires :
- Un réseau Encodeur (Encoder Network) : il analyse la dernière image calculée par le GPU et la compresse sous la forme d’une représentation mathématique dense et légère appelée embedding numérique.
- Un réseau Décodeur (Decoder Network) : il récupère cet embedding compact et le fusionne avec les vecteurs de mouvement (motion vectors) du moteur 3D ainsi qu’avec les états d’entrée les plus récents de la manette (angle d’inclinaison des joysticks analogiques, course des gâchettes adaptatives, pressions de boutons) pour générer la ou les frames à venir.
En injectant le signal brut de la manette au cœur même de l’inférence neuronale, le décodeur sait dans quelle direction la caméra commence à tourner plusieurs millisecondes avant que ce déplacement ne se traduise dans la géométrie 3D du moteur de jeu. Cette synergie entre capteurs matériels et intelligence artificielle fait directement écho aux nouveaux brevets de Sony autour de la future DualSense 2.0 pour la PlayStation 6, où la précision de lecture des commandes devient un pilier du pipeline graphique.
Voir les disponibilités sur Amazon (Manette DualSense PS5)→
Prédiction multi-frames, apprentissage auto-supervisé et horizon PlayStation 6
Au-delà de la prise en charge des commandes du joueur, le document déposé auprès de l’USPTO révèle trois mécanismes d’ingénierie particulièrement ingénieux pour garantir la stabilité du rendu sur console :
- La prédiction d’images multiples (Multi-Frame Prediction) : à partir d’un seul embedding source et du flux continu des entrées manette, le décodeur peut extrapoler plusieurs images successives si le GPU traverse une scène extrêmement lourde en Ray Tracing.
- Un mécanisme de repli non-IA (Hardware Fallback) : si les unités matricielles (NPU ou Tensor) sont saturées ou si l’indice de confiance de la prédiction chute, le système bascule instantanément sur un algorithme déterministe classique qui décale les blocs de pixels via les vecteurs de mouvement.
- L’entraînement auto-supervisé (Self-Supervised Learning) : le réseau de neurones peut s’entraîner directement sur des flux vidéo de gameplay sans aucun étiquetage humain. Il prédit l’image N+1, puis compare automatiquement son résultat avec la véritable image N+1 dès que le GPU finit de la calculer, ajustant ses poids synaptiques pour minimiser l’écart.

Si le dépôt d’un brevet ne garantit jamais une implémentation commerciale immédiate, ces travaux s’alignent avec la feuille de route tracée par l’architecte Mark Cerny dans le cadre du projet conjoint Project Amethyst mené avec AMD. Après avoir posé les fondations de la mise à l’échelle spectrale avec le PSSR (PlayStation Spectral Super Resolution) sur la PlayStation 5 Pro, Sony prépare manifestement la brique suivante pour la future PlayStation 6 : une génération d’images neuronale affranchie de la pénalité d’input lag.
Voir les disponibilités sur Amazon (PlayStation 5 Pro)→
Mon regard : pourquoi l’extrapolation guidée par la manette est le vrai chaînon manquant du rendu neuronal
En tant que spécialiste des architectures de Deep Learning appliquées au graphisme temps réel, je considère ce brevet de Denis Dupeyron comme l’une des pistes les plus lucides publiées ces dernières années. Jusqu’ici, les constructeurs de GPU ont traité la génération d’images comme un problème purement visuel, presque cinématographique : on observe deux images passées et on devine le milieu. Or, un jeu vidéo n’est pas un film passif, c’est une boucle cybernétique fermée par les mains du joueur.
À mes yeux, conditionner le décodeur latent par le vecteur d’état de la DualSense change toute l’équation mathématique. Au lieu de subir le changement de caméra comme une anomalie imprévisible, le réseau de neurones reçoit l’intention causale du joueur à l’instant exact où le pouce incline le stick. Si les équipes de Sony et d’AMD parviennent à faire tourner cet encodeur-décodeur en moins de deux millisecondes sur les futurs accélérateurs matriciels de la PlayStation 6, la barrière entre fluidité synthétique et réactivité compétitive pourrait enfin disparaître.
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Américaine installée dans la périphérie de New York, Chaya « Chayane » a passé 5 ans à Montréal pour ses études d'ingénierie logicielle avant de revenir dans sa région natale. Développeuse Full-Stack et chercheuse en architectures de Deep Learning et d'IA, elle explore les réseaux neuronaux et l'optimisation algorithmique tout en concevant les outils de Retrocharting et Gamescharting aux côtés de Grimtag. Gamer depuis plus de 20 ans, collectionneuse passionnée de l'univers Nintendo et de la saga The Legend of Zelda, elle a arpenté Azeroth sur World of Warcraft avant de mettre son expertise technique au service de l'analyse vidéoludique.