576 GPU fusionnés par fibre optique et 15 Exaflops : comment NVIDIA transforme un rack Rubin Ultra en une seule puce géante
Faire travailler 576 processeurs graphiques d’architecture Rubin Ultra comme s’ils ne formaient qu’une seule et unique carte graphique géante : tel est le défi d’ingénierie présenté par NVIDIA lors de l’Open Compute Project (OCP) Global Summit. En remplaçant les pistes en cuivre traditionnelles par de l’optique co-packagée (CPO) reliée à l’interconnexion NVLink 7 au sein de son châssis refroidi par liquide Kyber, le fondeur californien prépare pour 2027 une plateforme capable d’atteindre 15 Exaflops en inférence FP4 et d’entraîner des modèles d’intelligence artificielle dépassant les 10 000 milliards de paramètres.
Du châssis Oberon NVL72 au rack Kyber NVL576 : 576 puces réunies dans un domaine unique
Jusqu’ici, les infrastructures de calcul de NVIDIA reposaient sur le châssis Oberon NVL72, conçu pour interconnecter 72 accélérateurs graphiques au sein d’une même armoire serveur, un format que conservera encore la première génération Vera Rubin « VR200 ». Pour l’étape suivante, baptisée Vera Rubin Ultra NVL576 et attendue l’an prochain, les ingénieurs de Santa Clara changent radicalement d’échelle avec l’architecture rack Kyber, intégralement refroidie par liquide et conforme aux standards modulaires de l’Open Compute Project (OCP).
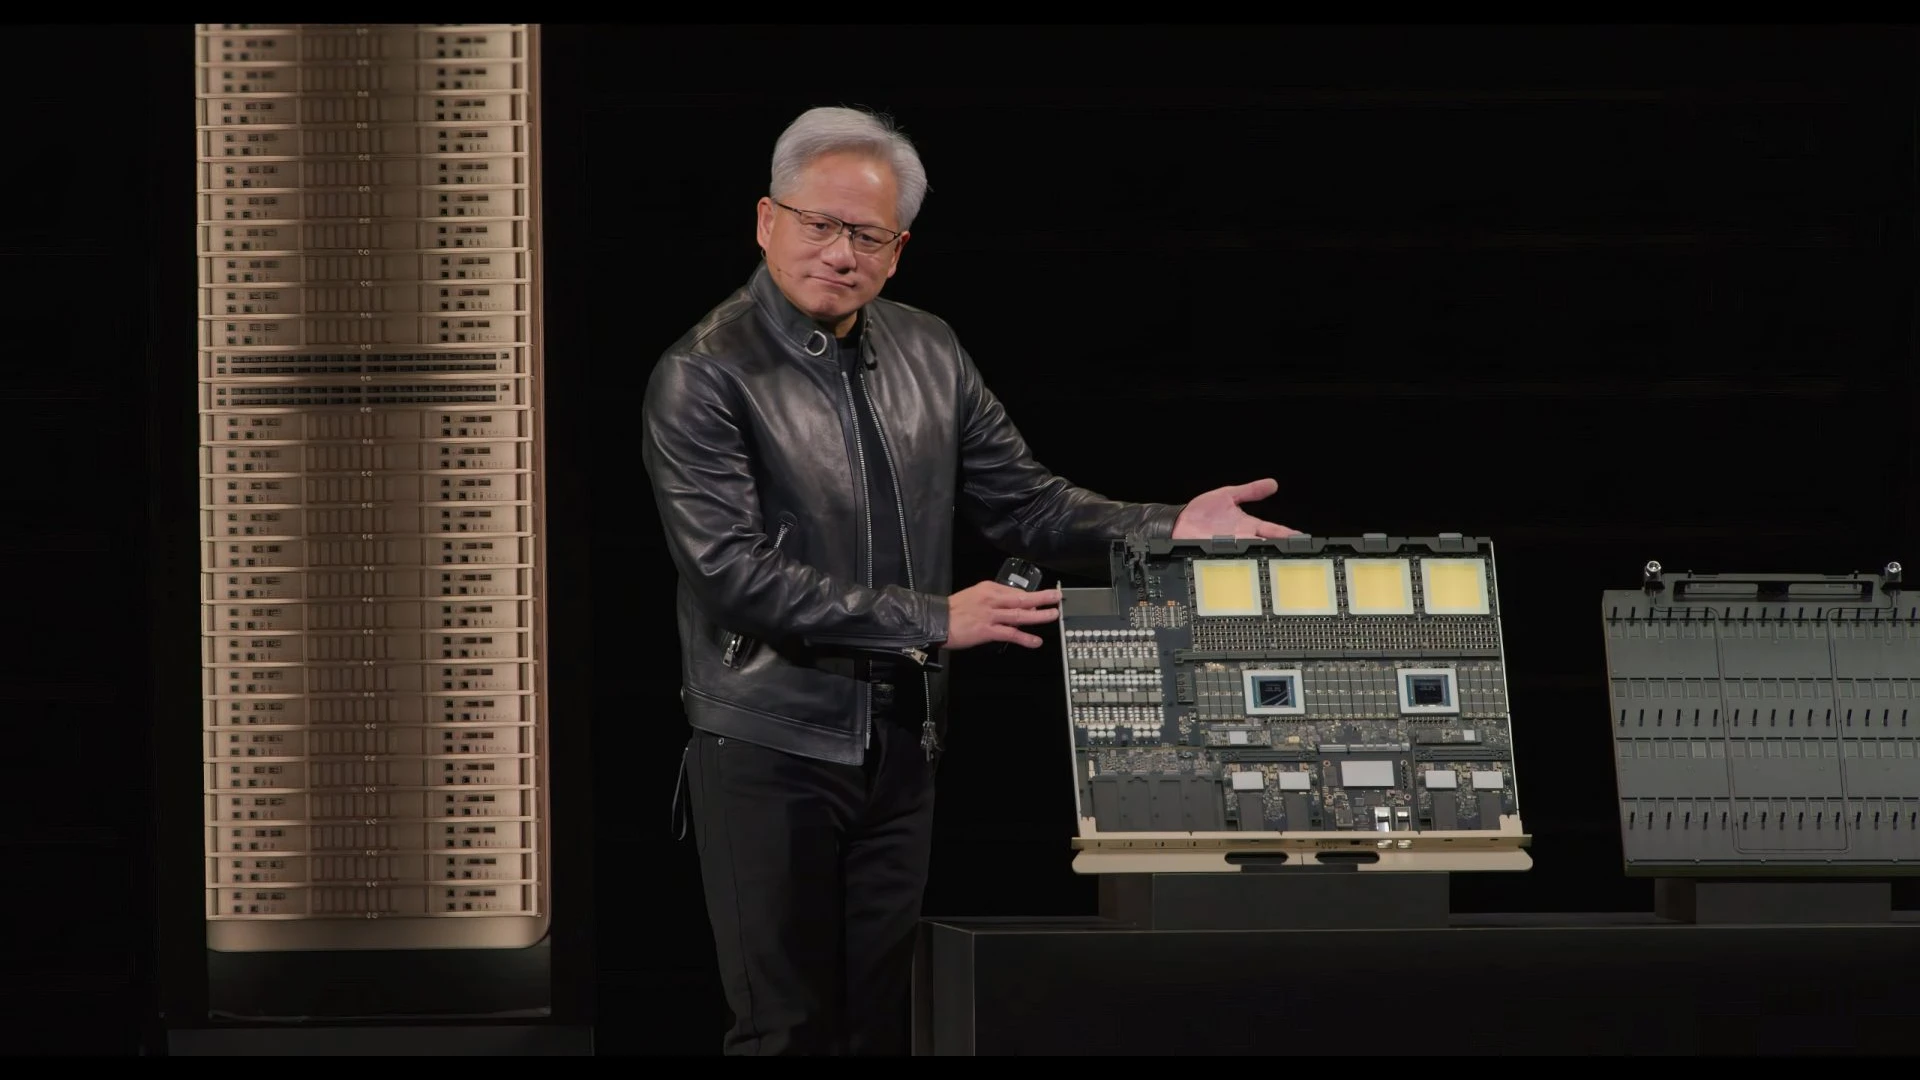
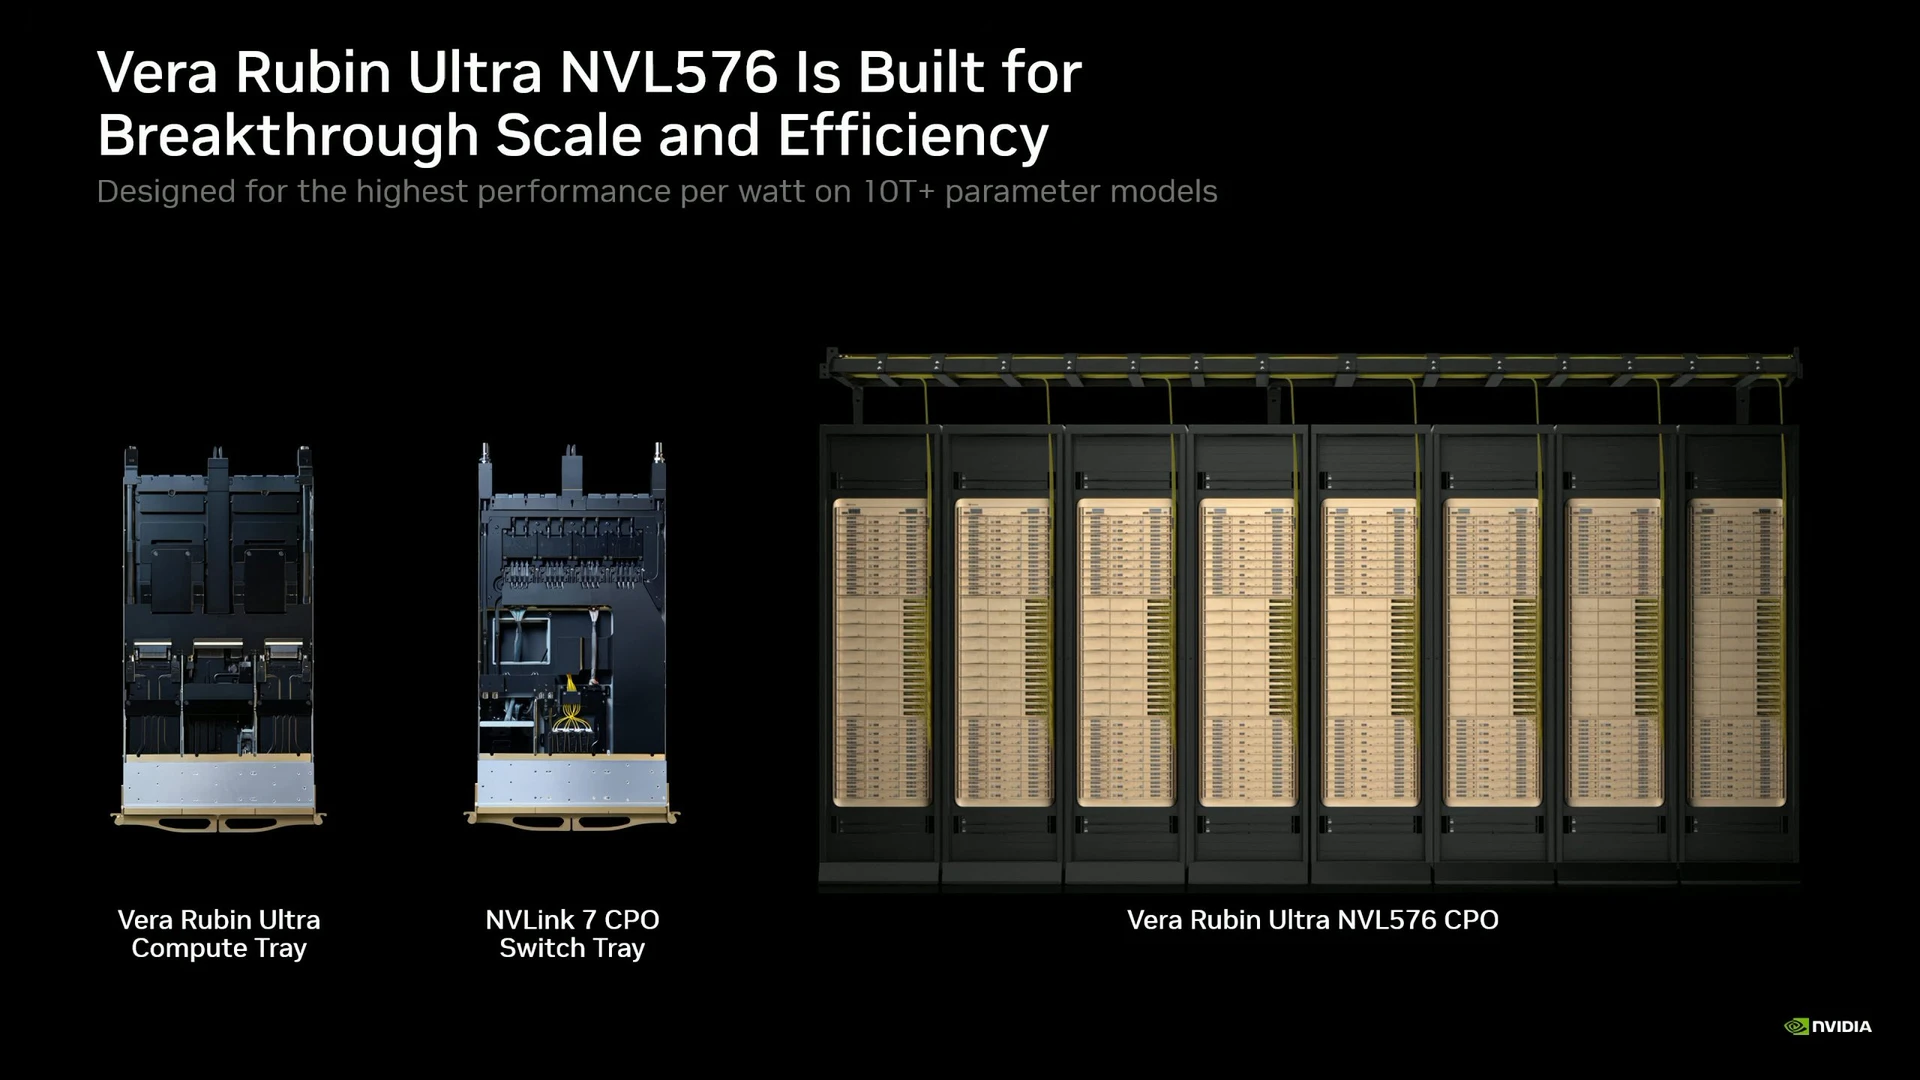
Lors de sa présentation technique à l’OCP Global Summit, Ian Buck, vice-président et directeur général de la division Hyperscale et Calcul Haute Performance (HPC) chez NVIDIA, a dévoilé pour la première fois les entrailles physiques de cette machine hors norme. Chaque tiroir de calcul (Vera Rubin Ultra Compute Tray) embarque deux GPU Rubin Ultra associés à un processeur central Vera doté de 88 cœurs ARM personnalisés Olympus, le tout sous refroidissement liquide direct. Au lieu de relier des grappes disparates par un réseau classique sujet à la latence, l’armoire Kyber fusionne huit fois plus de puces qu’un système NVL72 pour réunir 576 GPU dans un domaine de calcul unifié.
« Il ne s’agit plus de 72 GPU dans un seul rack, mais bien de 576 GPU intégralement reliés par NVLink. Nous utilisons notre tiroir de commutation NVLink CPO de nouvelle génération ainsi que notre tiroir Vera Rubin Ultra, tous deux basés sur les standards OCP. Ces petites fibres jaunes relient directement les moteurs optiques entre eux pour réunir tous ces GPU et ces racks individuels en un seul GPU géant de 576 puces. Ce sera le GPU géant NVLink offrant le meilleur rendement énergétique par watt de la planète, conçu pour nous emmener vers les modèles à 10 000 milliards de paramètres dès l’année prochaine. »
Ian Buck, vice-président et directeur général Hyperscale et HPC chez NVIDIA (OCP Global Summit)
Pourquoi l’optique co-packagée (CPO) supplante le cuivre à l’échelle du pétaoctet
Pour comprendre le basculement de NVIDIA vers le CPO (Co-Packaged Optics), il faut observer les limites physiques du cuivre. Lorsque les débits franchissent plusieurs térabits par seconde par puce, les liaisons électriques en cuivre subissent une atténuation sévère du signal au-delà de quelques dizaines de centimètres et dissipent une quantité critique de chaleur. Pour interconnecter 576 accélérateurs sur plusieurs baies juxtaposées sans perdre la cohérence mémoire d’un GPU unique, la lumière devient indispensable.
Dans le tiroir NVLink 7 CPO Switch Tray dévoilé par Ian Buck, les convertisseurs électro-optiques sont soudés au plus près du silicium de commutation. Des faisceaux de fibres optiques jaunes acheminent directement les impulsions lumineuses entre les moteurs photoniques, portant la bande passante globale d’interconnexion NVLink 7 à 1,5 Po/s (pétaoctet par seconde) à l’échelle du rack, complétée par des contrôleurs réseau ConnectX-9 Spectrum culminant à 115,2 To/s. De son côté, Jensen Huang, PDG de NVIDIA, a confirmé lors du GTC Berlin que les commutateurs et baies à optique co-packagée sont désormais entrés en production de volume, balayant les spéculations sur d’éventuels retards de rendement photonique face à l’architecture géante Helion d’AMD et ses 32 768 cœurs Zen 6.

Quatre réticules par puce, 365 To de mémoire HBM4e et déploiement en 14 jours
Au-delà de la photonique, la fiche technique de chaque puce Rubin Ultra donne le vertige. Contrairement à une puce monolithique classique limitée par la taille du masque photolithographique chez TSMC, chaque processeur Rubin Ultra assemble quatre dies de taille réticulaire (4-reticle GPU) entourés d’un maximum de 1 To de mémoire vive HBM4e empilée. À l’échelle d’une armoire complète, la plateforme aligne des chiffres inédits dans l’industrie des semi-conducteurs :
- Puissance de calcul IA : jusqu’à 15 Exaflops en inférence FP4 et 5 Exaflops en entraînement FP8, soit une densité de calcul multipliée par 14 par rapport au serveur Blackwell Ultra GB300 NVL72.
- Capacité et débit mémoire : 365 To de mémoire HBM4e mutualisée par rack complet, délivrant une bande passante mémoire cumulée de 4,6 Po/s (huit fois supérieure à la génération actuelle).
- Interconnexion optique et réseau : bus interne NVLink 7 sur optique co-packagée (CPO) à 1,5 Po/s et réseau ConnectX-9 Spectrum à 115,2 To/s.
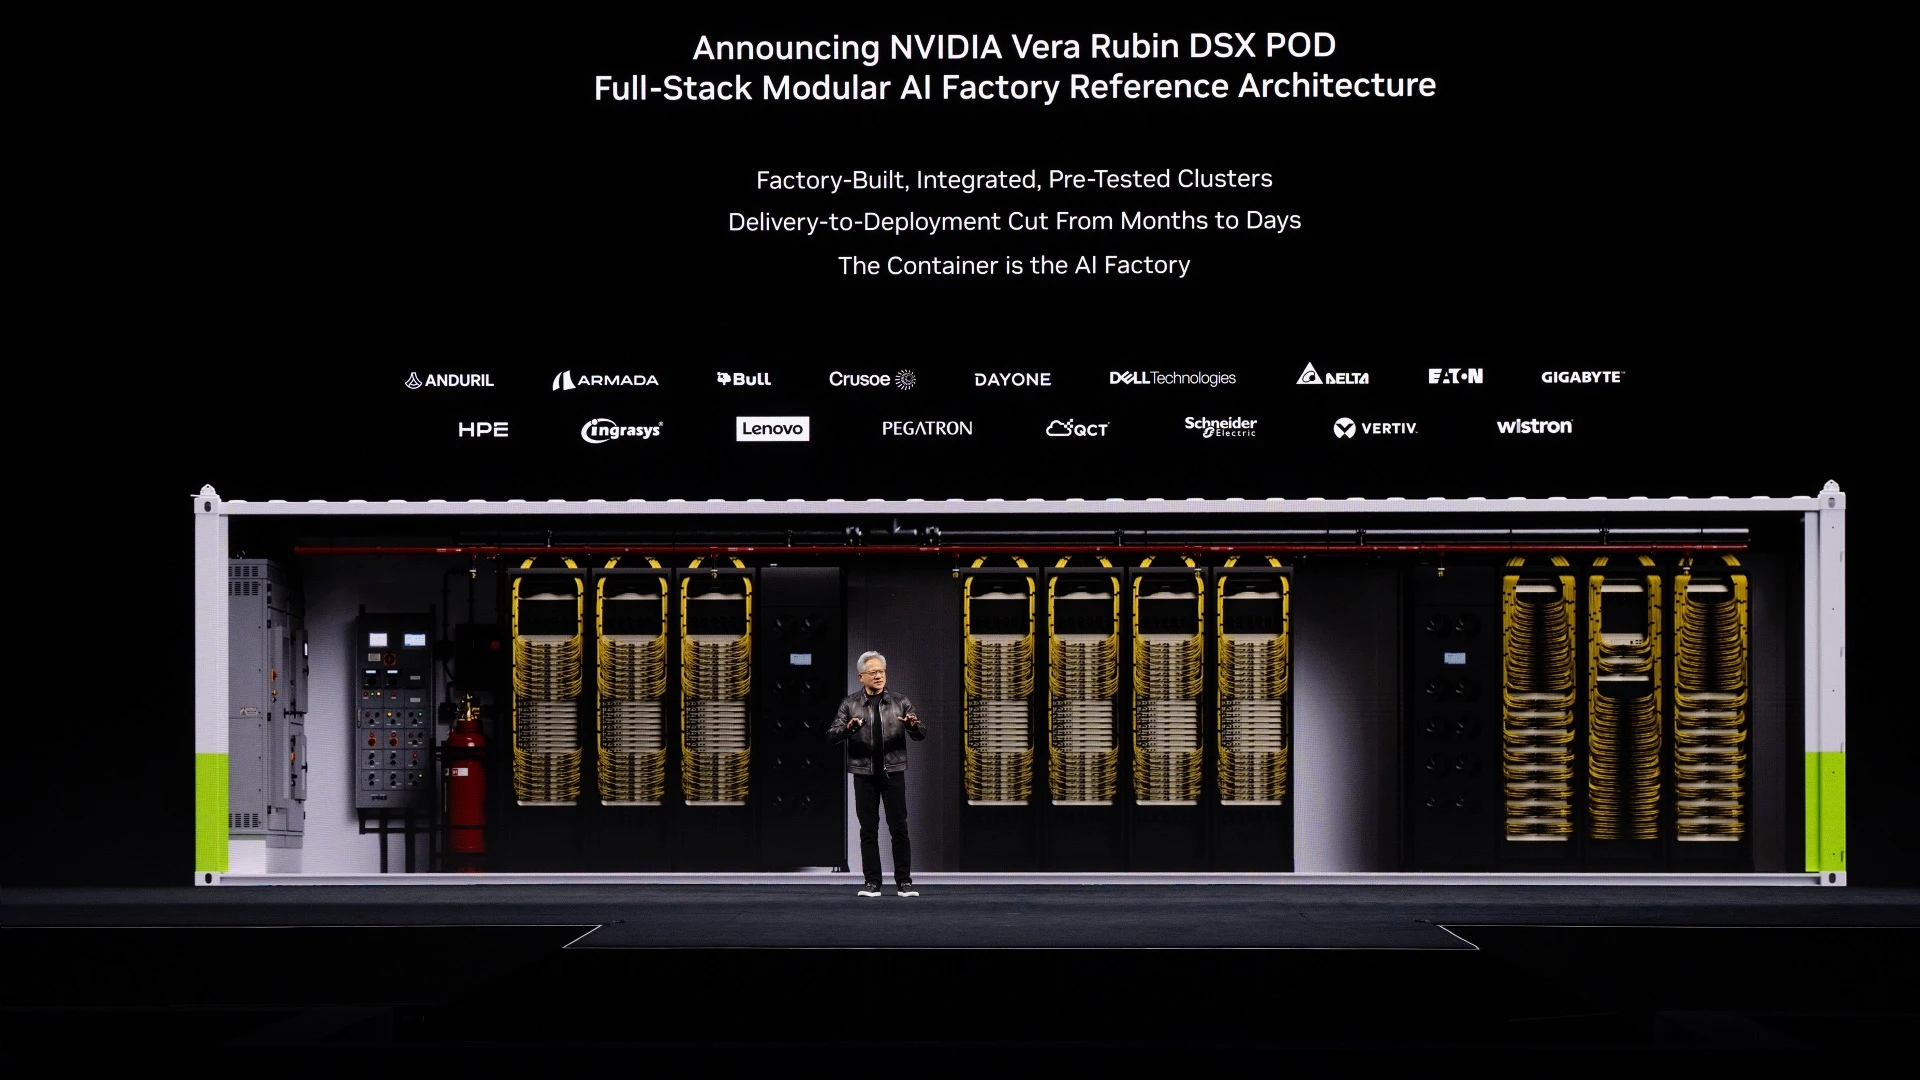
- Déploiement industriel accéléré : grâce à la conception modulaire sans câble externe héritée des normes OCP, le temps d’insertion d’un tiroir passe de plusieurs heures à quelques minutes, tandis que l’architecture de référence DSX Pod en conteneur pré-testé réduit la mise en service d’un centre de calcul complet de plusieurs mois à seulement 14 jours.
Mon banc d’essai : ce que l’ogre Rubin Ultra implique pour nos futures GeForce RTX
En analysant l’architecture physique de ce monstre NVL576 depuis mon banc de test, une réalité industrielle saute immédiatement aux yeux : la voracité en silicium et en mémoire de la feuille de route professionnelle de NVIDIA. Chaque GPU Rubin Ultra mobilise à lui seul l’équivalent de quatre dies à la limite du réticule de gravure, associés à douze ou seize empilements de mémoire HBM4e sur un interposeur géant. Lorsqu’un seul rack Kyber engloutit 576 de ces processeurs quadri-réticulaires, ce sont des milliers de wafers TSMC et une part colossale de la capacité mondiale d’encapsulation avancée CoWoS qui sont réservés en priorité aux hyperscalers.
Pour nous, joueurs et assembleurs de configurations PC haut de gamme, cette course au gigantisme explique directement pourquoi NVIDIA protège ses marges sur les centres de données et pourquoi le report de la génération grand public GeForce RTX 60 basée sur Rubin à 2028 s’inscrit dans une logique implacable d’allocation des lignes de production. Si l’optique co-packagée et l’alimentation haute tension 800 VDC posent des jalons d’efficacité remarquables pour l’industrie, elles confirment surtout que les puces GeForce RTX actuelles et futures continueront de se disputer chaque millimètre carré de silicium avec des armoires serveur valorisées à plusieurs dizaines de millions de dollars.
Voir les disponibilités sur Amazon→
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Passionné de hardware et de jeu vidéo, Arthur « Heimdall » navigue entre la France et l'Angleterre où il travaille dans la vente de solutions logicielles B2B. Diplômé d'école de commerce et passionné de bancs d'essai, il monte et démonte des PC depuis son enfance, traquant chaque degré thermique et chaque milliseconde de latence d'affichage. Joueur éclectique passé par Assassin's Creed et Roblox, c'est sur les raids de World of Warcraft qu'il a rencontré Grimtag et Chaya avant de rejoindre l'aventure Pro-Gamer.