Plus de 50 000 cœurs CUDA et NVLink 7 sur une seule puce : NVIDIA dévoile le GPU Rubin HPC pour 2028
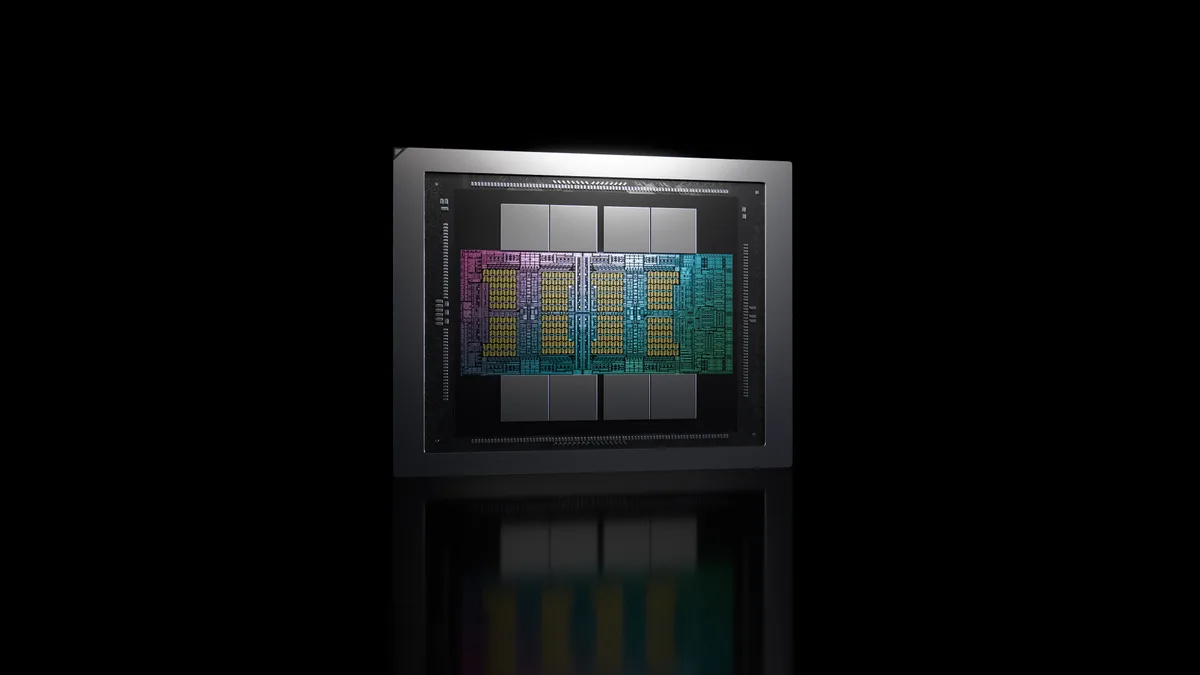
Franchir le cap symbolique des 50 000 cœurs CUDA sur un seul GPU n’appartient plus à la science-fiction. À l’occasion de l’ouverture de la conférence SC26 (Supercomputing 2026) ce 16 novembre 2026, NVIDIA a officiellement levé le voile sur le Rubin HPC, un nouveau processeur graphique intégré à la plateforme NVIDIA Vera Rubin et taillé pour les simulations scientifiques, l’ingénierie industrielle et l’analyse de données à grande échelle.
Pour mesurer le gouffre architectural que représente une telle densité de silicium, il suffit de regarder nos boîtiers PC actuels : une carte graphique grand public de pointe comme la GeForce RTX 5090 (basée sur la puce GB202 Blackwell) embarque 21 760 cœurs CUDA actifs. Avec plus de 50 000 unités de calcul sur une unique puce, le Rubin HPC plus que double la jauge matérielle d’un GPU monolithique.
Plus de 50 000 cœurs CUDA, NVLink de 7e génération et accélération des données éparses
Multiplier les unités de calcul sur un die géant pose toutefois un défi physique bien connu des architectes de processeurs : éviter que des dizaines de milliers de cœurs ne tournent à vide en attendant que la mémoire vive leur livre les opérandes. Dans les modèles climatiques, la mécanique des fluides, l’analyse génomique ou la physique des matériaux, le processeur doit constamment piocher quelques valeurs dispersées au cœur d’un océan de plusieurs téraoctets de données.
Après avoir récemment ajusté certains paramètres de sa feuille de route initiale, comme l’avait illustré la révision des fréquences HBM4 et du bus NVLink 6 sur Vera Rubin, la firme de Santa Clara inaugure sur cette déclinaison Rubin HPC deux briques matérielles majeures :
- Une accélération matérielle des données éparses (Sparse Data Acceleration) : un moteur dédié qui alimente en flux tendu les plus de 50 000 cœurs CUDA afin d’optimiser les opérations sur matrices creuses (sparse matrix), les calculs de stencils, les tris et les réductions.
- L’interconnexion NVIDIA NVLink de 7e génération : alors que l’architecture Vera Rubin standard repose sur le NVLink 6, ce GPU Rubin HPC étrenne le NVLink 7 pour décupler la bande passante de GPU à GPU au sein des grappes de supercalculateurs.
- L’intégration des bibliothèques NVIDIA CUDA-X : une suite d’algorithmes pré-optimisés permettant aux agents d’intelligence artificielle d’enchaîner l’exploration de molécules ou de matériaux et leur validation par simulation physique en réduisant drastiquement le temps de calcul.
Un lancement fixé à 2028 qui éclaire l’avenir des GPU PC et des futures GeForce RTX 60
Selon Ian Buck, vice-président en charge du calcul haute performance et de l’hyperscale chez NVIDIA, cette architecture équilibrée vise directement les laboratoires où des agents autonomes testent des milliers d’hypothèses matérielles ou chimiques avant tout prototypage physique : « Pour les agents qui s’attaquent à la science et à l’ingénierie, une simulation plus rapide signifie une découverte plus rapide. Rubin HPC accélère les simulations que les agents utilisent pour tester leurs idées et orienter leurs prochaines étapes. »
Le communiqué officiel précise que le NVIDIA Rubin HPC sera disponible en 2028. Pour les joueurs PC et les observateurs du marché des composants, cette échéance comporte deux enseignements directs. D’une part, la capacité de NVIDIA à loger plus de 50 000 cœurs CUDA sur une puce confirme le potentiel de miniaturisation dont hériteront, à terme, les déclinaisons grand public de l’architecture Rubin (attendues sous la bannière GeForce RTX 60). D’autre part, ce calendrier étiré jusqu’en 2028 rappelle que les wafers de gravure avancée chez TSMC et les lignes de mémoire rapide restent prioritairement absorbés par les centres de données, à l’heure où la flambée des puces GDDR7 de 3 Go bloque déjà la GeForce RTX 5080 24 Go sur le segment gaming.
Voir les disponibilités NVIDIA GeForce RTX sur Amazon→
Mon avis sur cette fiche technique
En analysant la fiche technique dévoilée par Ian Buck à l’occasion du SC26, je retiens surtout le changement de philosophie opéré par NVIDIA sur l’architecture Rubin. Empiler plus de 50 000 cœurs CUDA sur un seul GPU est une prouesse de gravure remarquable, mais c’est l’association du moteur d’accélération de données éparses et du NVLink de 7e génération qui constitue le vrai bond technologique. Sur mes bancs de test, je constate déjà que les cartes Blackwell les plus musclées sont souvent bridées par la bande passante mémoire plutôt que par leurs unités de calcul brutes. En forçant le mouvement des données à progresser au même rythme que le nombre de cœurs d’ici 2028, Rubin trace une voie technique fascinante, même s’il faudra s’armer de patience avant qu’une telle densité ne redescende dans nos configurations de jeu.
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Passionné de hardware et de jeu vidéo, Arthur « Heimdall » navigue entre la France et l'Angleterre où il travaille dans la vente de solutions logicielles B2B. Diplômé d'école de commerce et passionné de bancs d'essai, il monte et démonte des PC depuis son enfance, traquant chaque degré thermique et chaque milliseconde de latence d'affichage. Joueur éclectique passé par Assassin's Creed et Roblox, c'est sur les raids de World of Warcraft qu'il a rencontré Grimtag et Chaya avant de rejoindre l'aventure Pro-Gamer.