HBM4 ramenée à 9,6 Gbps et NVLink 6 abaissé à 3 To/s : pourquoi NVIDIA révise à la baisse les spécifications de Vera Rubin
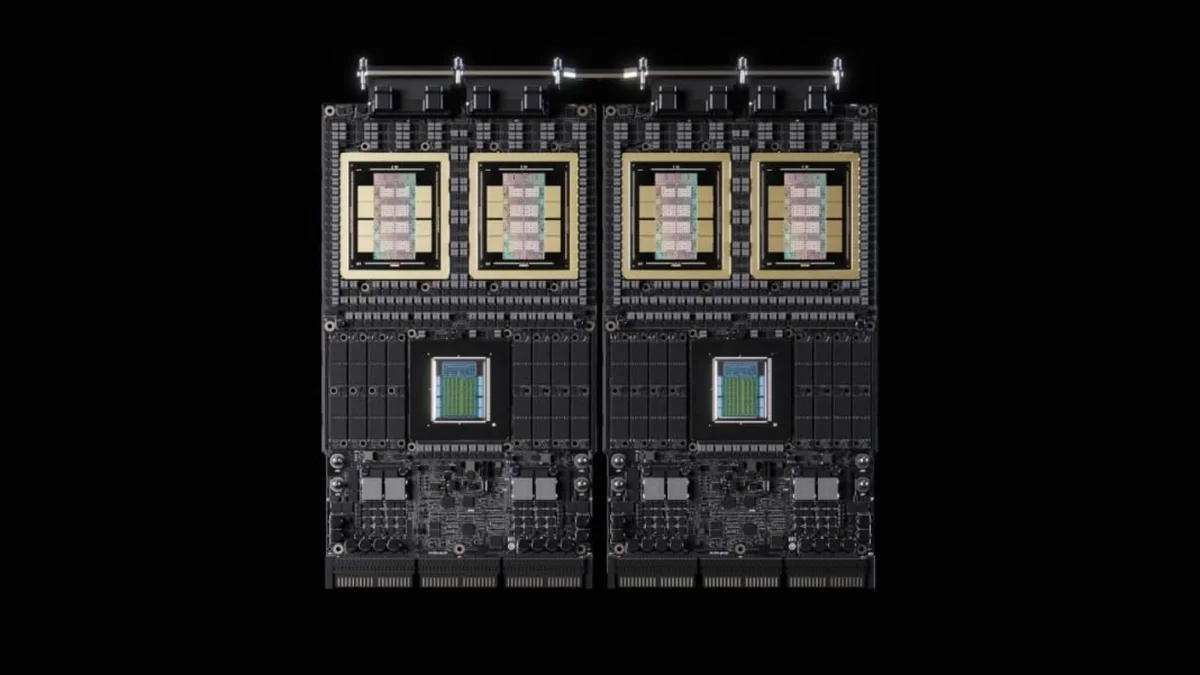
NVIDIA vient d’actualiser en silence la documentation technique officielle de sa plateforme Vera Rubin, appelée à succéder à l’architecture Grace Blackwell dans les centres de données d’intelligence artificielle et de calcul haute performance. Les nouvelles tables de spécifications affichent une révision à la baisse sur deux piliers matériels de la feuille de route : la fréquence par broche de la mémoire HBM4 recule de 11,7 Gbps à 9,6 Gbps, tandis que la bande passante bidirectionnelle de l’interconnexion NVLink 6 passe de 3,6 To/s à 3,0 To/s par GPU.
De 1 580 To/s à 1 400 To/s : l’impact du passage de la HBM4 à 9,6 Gbps par broche
Le premier ajustement touche directement le sous-système mémoire des accélérateurs Rubin GPU. Alors que les spécifications préliminaires tablaient sur des piles HBM4 cadencées à 11,7 Gbps par broche (bien au-delà du plancher de base de 8 Gbps défini par le standard JEDEC), la fiche produit actualisée de NVIDIA ramène cette cible à 9,6 Gbps par broche, soit une réduction d’environ 17,9 % sur la fréquence d’horloge mémoire.
À capacité constante de 288 Go de HBM4 par GPU Rubin, cette révision se répercute mécaniquement sur les débits cumulés de toute la gamme :
- Par GPU Rubin individuel (288 Go HBM4) : la bande passante mémoire passe de 22 To/s à 19,25 To/s.
- Sur le module NVIDIA Vera Rubin Superchip (2 GPU Rubin + 1 CPU Vera, 576 Go HBM4) : le débit mémoire agrégé recule de 44 To/s à 38,5 To/s (-12,5 %).
- Sur le module NVIDIA Vera Rubin NVL4 (4 GPU Rubin + 2 CPU Vera, 1,1 To HBM4) : la bande passante s’établit désormais à 77 To/s.
- Sur la baie complète NVIDIA Vera Rubin NVL72 (72 GPU Rubin + 36 CPU Vera, 20,7 To HBM4) : la bande passante mémoire totale du rack descend de 1 580 To/s à 1 400 To/s (-11,4 %).
- Sur le serveur HGX Rubin NVL8 (8 GPU) : les valeurs affichées passent de 2,3 To pour 176 To/s à 2 To pour 130 To/s.
NVLink 6 et intégrité du signal : pourquoi NVIDIA abaisse la fréquence de Nyquist de 56 GHz à 47 GHz
Le second coup de rabot concerne la matrice d’interconnexion NVLink de sixième génération (NVLink 6). Sur chaque puce Rubin, le débit unidirectionnel passe de 1,8 To/s à 1,5 To/s, ramenant la bande passante bidirectionnelle de 3,6 To/s à 3,0 To/s par GPU (-16,7 %). Sur le Vera Rubin Superchip, le débit NVLink glisse ainsi de 7,2 To/s à 6,0 To/s (et 12 To/s sur la déclinaison NVL4), tandis que la bande passante globale d’un rack Vera Rubin NVL72 passe de 260 To/s à 216 To/s. Le lien cohérent NVLink-C2C reliant le processeur Vera (doté de 88 cœurs personnalisés NVIDIA Olympus et 176 threads) aux deux GPU Rubin reste en revanche intact à 1,8 To/s par Superchip et 65 To/s à l’échelle du rack.
La raison fondamentale de ce repli est d’ordre électrique : NVIDIA a abaissé la fréquence de Nyquist cible de ses lignes NVLink 6 de 56 GHz à 47 GHz. À ces fréquences ultra-élevées, maintenir l’intégrité du signal (Signal Integrity) à travers les contrôleurs SerDes, les pistes du circuit imprimé, le fond de panier en cuivre (copper backplane) et les interposeurs silicium impose des tolérances physiques extrêmes. Cette contrainte s’ajoute directement à la bataille mondiale autour des substrats ABF à Taïwan où NVIDIA, AMD et Intel ont injecté 5 milliards de dollars pour sécuriser leurs boîtiers multicouches de nouvelle génération.
| Caractéristique technique | Vera Rubin NVL72 (Ancienne cible) | Vera Rubin NVL72 (Fiche révisée) | Vera Rubin Superchip (Fiche révisée) |
|---|---|---|---|
| Configuration CPU / GPU | 72 GPU Rubin | 36 CPU Vera | 72 GPU Rubin | 36 CPU Vera | 2 GPU Rubin | 1 CPU Vera (88 cœurs Olympus) |
| Vitesse mémoire HBM4 par broche | 11,7 Gbps | 9,6 Gbps | 9,6 Gbps |
| Capacité & Bande passante HBM4 | 20,7 To | 1 580 To/s | 20,7 To | 1 400 To/s | 576 Go | 38,5 To/s (au lieu de 44 To/s) |
| Bande passante NVLink 6 | 260 To/s (3,6 To/s par GPU) | 216 To/s (3,0 To/s par GPU) | 6,0 To/s (au lieu de 7,2 To/s) |
| Lien CPU-GPU NVLink-C2C | 65 To/s | 65 To/s | 1,8 To/s |
| Calcul Inférence NVFP4 / FP32 | 3 600 PFLOPS / 9 360 TFLOPS | 3 600 PFLOPS / 9 360 TFLOPS | 100 PFLOPS / 260 TFLOPS |
| Enveloppes électriques (Rack) | Non détaillées | MaxP : 227 kW | MaxQ : 187 kW | MaxLPS : 156 kW | Refroidissement liquide (entrée à 45 °C) |
Puissance de calcul préservée, profils à 227 kW et conséquences pour les GPU gaming GeForce RTX
Malgré ce recul sur les débits mémoire et réseau, les unités de calcul des puces Rubin conservent l’intégralité de leurs fréquences théoriques : un rack Vera Rubin NVL72 délivre toujours 3 600 PFLOPS en inférence NVFP4 (50 PFLOPS par GPU), 2 520 PFLOPS en entraînement NVFP4, 1 260 PFLOPS en FP8/FP6, 9 360 TFLOPS en FP32 et 2 400 TFLOPS en FP64. La nouvelle documentation dévoile également trois profils de consommation électrique pour la baie complète de 1 296 puces (refroidie par liquide avec une eau d’admission à 45 °C) : un mode MaxP à 227 kW, un mode MaxQ à 187 kW et un profil haute efficacité MaxLPS à 156 kW.
Pour les joueurs PC, cet arbitrage industriel sur les serveurs IA est loin d’être anodin. En acceptant de relâcher la bride électrique sur le bus mémoire HBM4 et le SerDes NVLink 6, NVIDIA améliore immédiatement ses rendements de fabrication (yields) sur les lignes de gravure TSMC N3P et d’encapsulation avancée CoWoS-L. Moins de puces mises au rebut côté datacenters signifie moins de gaspillage de wafers de silicium, alors que les gammes grand public actuelles basées sur la mémoire GDDR7 restent sous forte demande et que les joueurs surveillent déjà notre comparateur de prix de jeux vidéo pour optimiser leur budget gaming face à l’inflation matérielle.
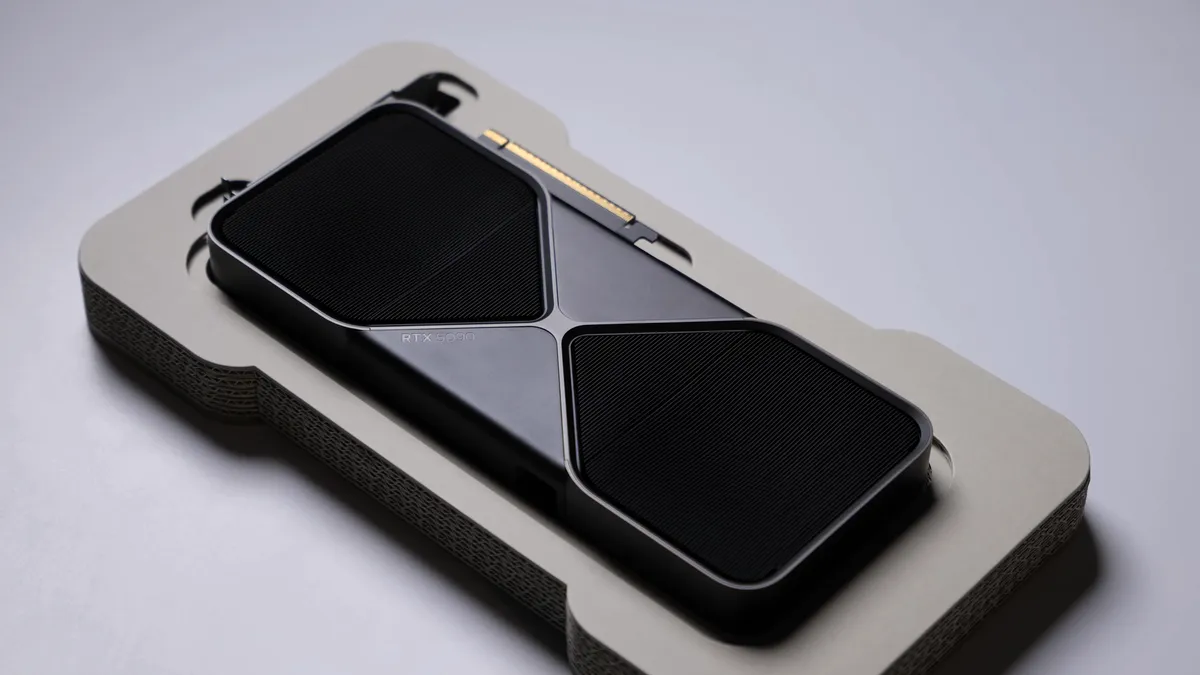
Carte Graphique NVIDIA GeForce RTX 5090 (32 Go GDDR7, Architecture Blackwell)
Mon banc d'essai
En examinant ces nouvelles courbes techniques sur mon banc d'essai, le choix des ingénieurs de Santa Clara relève d'un pragmatisme industriel implacable. Faire tourner huit piles HBM4 par GPU sur un interposeur géant à 11,7 Gbps par broche tout en maintenant une fréquence de Nyquist de 56 GHz sur des câbles cuivre de fond de panier exposait les baies NVL72 à un taux d'erreur binaire et à une dissipation thermique rédhibitoires en production de masse. Même ramenée à 38,5 To/s par Superchip et 1 400 To/s par baie, la plateforme Vera Rubin conserve une avance confortable sur l'architecture Grace Blackwell, tout en évitant d'engorger davantage les usines de TSMC avant la déclinaison grand public des futures architectures GeForce.
Voir les disponibilités NVIDIA GeForce RTX 5080 sur Amazon→
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Passionné de hardware et de jeu vidéo, Arthur « Heimdall » navigue entre la France et l'Angleterre où il travaille dans la vente de solutions logicielles B2B. Diplômé d'école de commerce et passionné de bancs d'essai, il monte et démonte des PC depuis son enfance, traquant chaque degré thermique et chaque milliseconde de latence d'affichage. Joueur éclectique passé par Assassin's Creed et Roblox, c'est sur les raids de World of Warcraft qu'il a rencontré Grimtag et Chaya avant de rejoindre l'aventure Pro-Gamer.