De 1,2 à 79 FPS et 96 % de VRAM économisée : comment la mise à jour DirectX Raytracing transforme les GPU GeForce RTX, Radeon RX et Intel Arc
Huit ans et demi après l’introduction initiale de DirectX Raytracing (DXR) en mars 2018, les ingénieurs de l’équipe DirectX chez Microsoft viennent de publier simultanément les kits de développement DirectX 12 Agility SDK 1.620 Retail et Agility SDK 1.722 Preview. Détaillée par Ross Coken, Isaac Bender et Amar Patel sur le blog officiel DirectX Developer, cette mise à jour matérielle et logicielle constitue la refonte architecturale la plus profonde du raytracing temps réel sur Windows depuis sa création, dans la continuité directe du Shader Model 6.9 (DXR Tier 1.2) qui avait introduit le Shader Execution Reordering (SER) et les Opacity Micromaps (OMM) en février 2026.
L’objectif de cette révision est de faire sauter le principal goulet d’étranglement des moteurs 3D actuels : le coût prohibitif en temps processeur, en calcul GPU et en mémoire vidéo (VRAM) de la reconstruction des structures d’accélération géométriques dans les mondes ouverts dynamiques et les scènes à très haute densité polygonale.
Clustered Geometry (CLAS) : en finir avec les proxys basse définition en raytracing
Jusqu’à présent, le calcul du raytracing dans DirectX 12 reposait sur des structures d’accélération de bas niveau (BLAS, pour Bottom-Level Acceleration Structures) rigides et coûteuses à reconstruire dès qu’un maillage se déforme, s’anime ou est chargé à la volée. Pour préserver le budget d’image, la plupart des studios devaient tricher en envoyant au moteur de raytracing des maillages simplifiés (proxys basse résolution) différents de la géométrie affichée en rastérisation classique, ce qui provoquait des décalages visibles sur les ombres portées et les reflets.
Avec l’Agility SDK 1.722 Preview et le Shader Model 6.10, Microsoft standardise au sein de l’API Direct3D 12 la technologie Clustered Geometry, jusqu’ici cantonnée à des implémentations propriétaires comme l’API RTX Mega Geometry de NVIDIA. Le principe consiste à découper la géométrie en petits groupes modulaires réutilisables appelés CLAS (Cluster Level Acceleration Structures), contenant chacun jusqu’à 256 triangles et 256 sommets.

Plutôt que de rebâtir un objet complet depuis ses triangles bruts à chaque image, le GPU assemble un Cluster BLAS à partir de références CLAS déjà calculées, directement compatibles avec les pipelines de géométrie par meshlets (comme Nanite sous Unreal Engine 5). Pour les objets animés ou procéduraux, l’API introduit des Cluster Templates : la topologie est précalculée une seule fois, et un simple shader de calcul (compute shader) instancie les nouvelles coordonnées de sommets à chaque image. Microsoft ajoute également le format d’encodage en virgule fixe COMPRESSED1, qui stocke des décalages entiers compacts autour d’un point d’ancrage partagé au lieu de trois valeurs flottantes complètes par sommet.
De 1,2 FPS à 79 FPS : un gain de 66x mesuré par Microsoft
Pour illustrer l’impact concret de cette architecture, Amar Patel a publié les relevés de performance du nouveau bac à sable officiel D3D12RaytracingClusteredGeometry exécuté sur une carte graphique AMD Radeon RX 9070. Sur une scène procédurale et animée soumise à une reconstruction continue, l’écart entre la méthode BLAS traditionnelle et la géométrie par clusters change radicalement la donne :
| Métrique (Scène test D3D12 sur Radeon RX 9070) | Reconstruction BLAS classique | Clustered Geometry (SDK 1.722) | Écart mesuré |
|---|---|---|---|
| Framerate moyen | 1,2 FPS | 79 FPS | Gain de ~66x |
| Temps GPU de préparation / build AS par image | 788 ms | 3,11 ms | ~254x plus rapide |
| Temps de tracé de rayons GPU par image | 72,6 ms | 9,27 ms | ~7,8x plus rapide |
| Mémoire AS géométrie animée (VRAM) | 6 794 Mio | 244 Mio | -96,4 % de mémoire |
| Mémoire totale des structures (TLAS inclus) | 7 519 Mio | 774 Mio | -89,7 % de mémoire |
En divisant par près de dix la consommation mémoire totale des structures d’accélération (qui passe de 7,5 Go à seulement 774 Mio), cette approche offre une bouffée d’oxygène décisive aux cartes graphiques dotées de 8 à 16 Go de VRAM lorsque le Path Tracing est activé.
Partitioned TLAS (PTLAS) et exécution indirecte 100 % pilotée par le GPU
Au niveau global de la scène, l’Agility SDK 1.722 inaugure les Partitioned Top-Level Acceleration Structures (PTLAS). Dans un monde ouvert classique, le déplacement d’une poignée d’entités ou la chute d’un décor obligeait souvent le moteur à reconstruire intégralement l’arbre principal de la scène (TLAS) à chaque image. Avec PTLAS, le graphe de scène est découpé en partitions spatiales indépendantes ainsi qu’en une partition globale réservée aux objets en mouvement perpétuel.
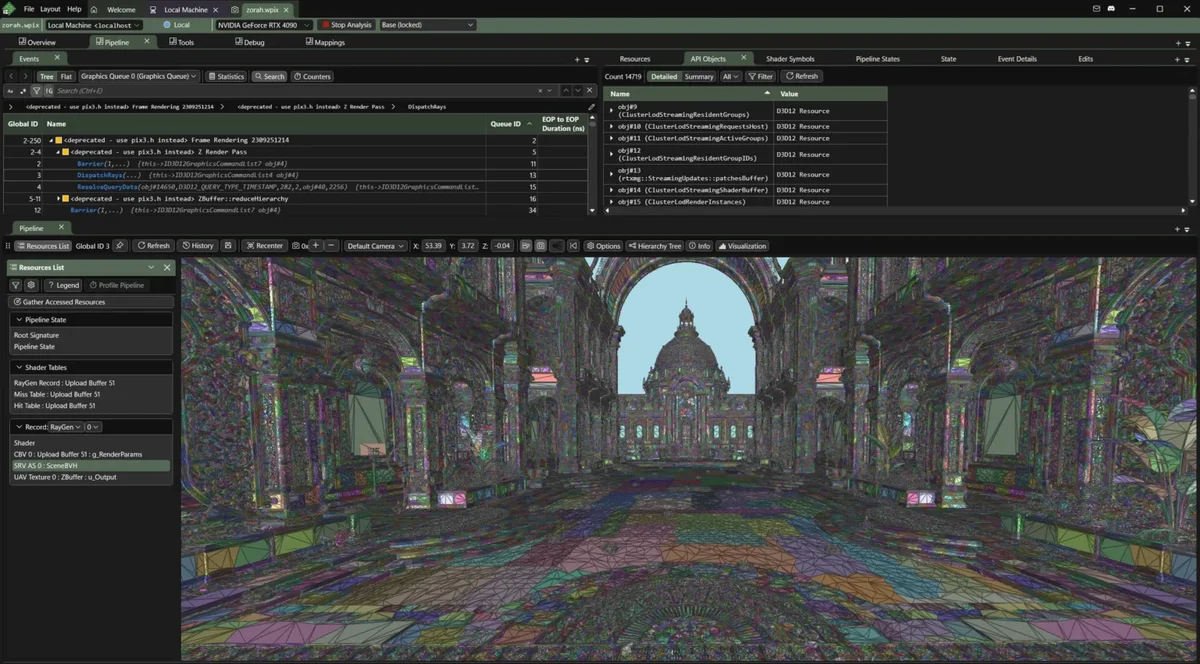
Ainsi, seules les régions ayant réellement subi une modification sont mises à jour via des écritures partielles (WRITE_INSTANCE ou UPDATE_INSTANCE). Dans la démo technique de chute de dominos (D3D12RaytracingPartitionedTLAS) portée depuis Vulkan par Pascal Gautron et les ingénieurs de NVIDIA, le temps de mise à jour de la scène chute de 2,88 ms en TLAS standard à seulement 0,79 ms avec PTLAS pour 4 702 instances modifiées. De plus, la nouvelle commande unifiée ExecuteIndirectRTASOperations() décharge totalement le processeur central (CPU) : le GPU génère et pilote lui-même ses listes de construction et d’instanciation via des tampons d’arguments indirects.
Agility SDK 1.620 Retail : Advanced Shader Delivery et diagnostics de crash GPU
En parallèle de cette préversion 1.722, Microsoft publie l’Agility SDK 1.620 Retail, immédiatement exploitable dans les jeux du commerce. Celui-ci enrichit le pipeline Advanced Shader Delivery de DirectX 12 qui réduit déjà de 95 % le temps de compilation des shaders grâce aux Partial Graphics Programs (permettant de réutiliser des briques de shaders précompilées entre plusieurs variantes de pipelines afin d’alléger les téléchargements) et à la prise en charge de bases de données multiples (Explicitly Specified PSDBs) découpées par DLC.
La version 1.620 passe également en statut commercial les DirectX Dump Files (fichiers .dxdmp détaillés par Greg Gonyea et Deepali Bhagvat pour analyser les crashs GPU directement sur les machines des joueurs), les barrières de synchronisation Fence Barriers Tier 1, les commandes asynchrones groupées (Batched Asynchronous Command List APIs dotées d’une couche d’émulation pour les anciens GPU) ainsi que l’interface d’exécution DirectX Compute Graph Compiler (DxCGC) dédiée aux modèles d’apprentissage automatique MLIR. Microsoft précise par ailleurs que le Shader Model 6.10 quittera son statut expérimental dès le début du mois de décembre 2026 avec la sortie de l’Agility SDK 1.621 Retail.
Quels GPU et pilotes NVIDIA, AMD, Intel et Qualcomm sont compatibles ?
Bonne nouvelle confirmée par Microsoft : Clustered Geometry, PTLAS et les builds indirects ne nécessitent aucun bloc matériel inédit au-delà des unités de raytracing existantes, mais reposent sur la validation des pilotes par chaque fondeur :
- NVIDIA (GeForce RTX) : Comme l’a confirmé Martin Stich (Senior Director of Engineering chez NVIDIA), l’ensemble des fonctionnalités de l’Agility SDK 1.722 (Clustered Geometry, PTLAS et builds indirects) ainsi que les nouveautés 1.620 sont pris en charge sur toutes les cartes graphiques GeForce RTX (des séries RTX 20 Turing et RTX 30 Ampere jusqu’aux RTX 40 Ada et RTX 50 Blackwell) via les pilotes Game Ready distribués dans la NVIDIA App.
- AMD (Radeon RX) : Rodney Andre (Corporate VP of Software Development chez AMD) annonce la prise en charge immédiate de Clustered Geometry et PTLAS sur les Radeon RX 9000 Series (architecture RDNA 4, dont les RX 9070 et RX 9070 XT) via le pilote AMD Software: Agility SDK Developer Preview Edition 26.20.12.01. Les fonctions commerciales du SDK 1.620 (Partial Graphics Programs, DirectX Dump Files, Fence Barriers Tier 1) sont quant à elles actives sur les Radeon RX 7000 (RDNA 3) et RX 9000 via le pilote 26.20.12.02, tandis que cette avancée complète la stratégie logicielle amorcée avec AMD FSR Diamond et son module de Ray Reconstruction.
- Intel (Arc et Core Ultra) : Matthäus Chajdas (Senior Principal Engineer chez Intel) confirme le support de Clustered Geometry et PTLAS dès aujourd’hui sur les cartes dédiées Intel Arc Série B (Battlemage) ainsi que sur les iGPU des processeurs Intel Core Ultra Série 2 (200V Lunar Lake) et Série 3 (Panther Lake) par le biais de l’Intel Graphics Beta Preview Feature Driver (build 931698).
- Qualcomm (Snapdragon) : L’intégration de Clustered Geometry et PTLAS sur les puces Snapdragon X2 est en cours de développement conjoint avec Microsoft, avec une sortie des pilotes Adreno ciblée pour le premier ou deuxième trimestre 2027.
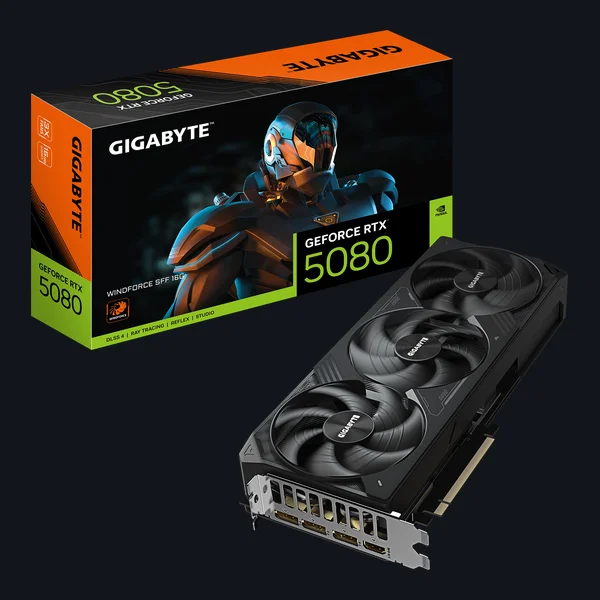
Carte Graphique NVIDIA GeForce RTX 5070 Ti (16 Go GDDR7)
- Compatibilité intégrale avec DirectX 12 Clustered Geometry, Partitioned TLAS et RTX Mega Geometry
- 16 Go de mémoire vidéo GDDR7 avec accélération matérielle Shader Execution Reordering (SER) et Opacity Micromaps
- Taillée pour le Path Tracing en 1440p et 4K avec DLSS 4 Multi-Frame Generation et Shader Model 6.10
Mon avis
C'est exactement le genre de chantier de fond qui a bien plus d'impact réel sur la fluidité de nos jeux PC que n'importe quel slogan marketing. Depuis 2018, le raytracing sous DirectX 12 traînait un boulet architectural majeur : chaque fois qu'un moteur comme l'Unreal Engine 5 voulait animer une forêt dense ou gérer des milliers d'objets dynamiques en ville, le processeur et la mémoire vidéo s'écroulaient sous le poids des reconstructions de structures BLAS et TLAS. En standardisant le découpage en clusters de 256 triangles et le partitionnement spatial directement au cœur de Direct3D 12, Microsoft transforme une technologie autrefois réservée à l'écosystème propriétaire de NVIDIA en un standard universel exploitable aussi bien sur une GeForce RTX que sur une Radeon RX 9070 ou une Intel Arc Battlemage. Mais le chiffre que je retiens avant tout, c'est cette chute de 96,4 % de la mémoire vidéo occupée par les structures animées : à une époque où le prix de la mémoire GDDR6 et GDDR7 flambe, économiser près de 6,5 Go de VRAM sur une scène complexe va littéralement sauver la mise des configurations équipées de 12 ou 16 Go dans les gros jeux de 2027.
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Passionné de hardware et de jeu vidéo, Arthur « Heimdall » navigue entre la France et l'Angleterre où il travaille dans la vente de solutions logicielles B2B. Diplômé d'école de commerce et passionné de bancs d'essai, il monte et démonte des PC depuis son enfance, traquant chaque degré thermique et chaque milliseconde de latence d'affichage. Joueur éclectique passé par Assassin's Creed et Roblox, c'est sur les raids de World of Warcraft qu'il a rencontré Grimtag et Chaya avant de rejoindre l'aventure Pro-Gamer.