1,3 PFLOPS dans seulement 350 Watts : comment Intel défie Nvidia avec son GPU D270 Crescent Island et 480 Go de mémoire
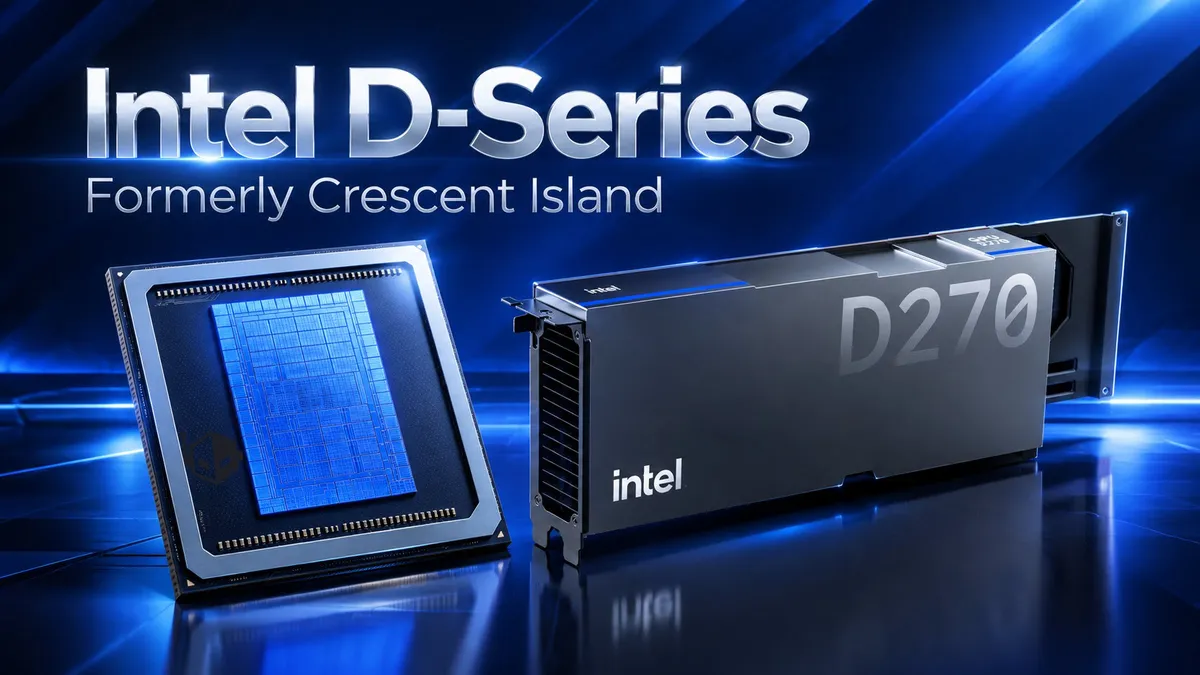
Intel profite du sommet OCP Global Summit 2026 pour dévoiler sa riposte sur le marché de l’intelligence artificielle en centre de données. Le fondeur de Santa Clara officialise sa nouvelle gamme d’accélérateurs Intel GPU D-Series, développée sous le nom de code Crescent Island, avec une carte de référence redoutable baptisée Intel GPU D270.
Le constat d’Intel est limpide : alors que l’inférence de modèles massifs dévore l’énergie des datacenters et que les puces Nvidia nécessitent des plomberies de refroidissement liquide hors de prix, la firme bleue propose une alternative taillée pour le rendement énergétique et le coût total de possession.
Architecture Xe3P : la purge complète des blocs graphiques
Au cœur du GPU D270 se trouve la microarchitecture Xe3P, déclinaison purement professionnelle et calcul de l’architecture Xe de 3e génération d’Intel. Pour maximiser la densité de calcul sur le silicium, les équipes d’ingénierie ont pris une décision radicale : supprimer intégralement les blocs de rastérisation 3D et les unités de ray tracing destinés au jeu vidéo.
Chaque millimètre carré de silicium est dédié aux opérations matricielles et vectorielles. La puce embarque 32 cœurs Xe3P répartis en quatre tranches de calcul (Compute Slices), totalisant 256 moteurs vectoriels et 256 unités matricielles XMX (Xe Matrix Extensions) à réseau systolique profond.
Cette structure s’accompagne d’une hiérarchie de mémoire cache musclée, comprenant 512 Ko de mémoire L1 et SLM dédiée par cœur (soit 16 Mo au global) et un cache L2 unifié de 32 Mo pour éviter tout goulot d’étranglement lors des échanges inter-cœurs.
1,3 PFLOPS pour 350 Watts et refroidissement passif par air
Sur le plan des performances brutes d’inférence, la D270 délivre jusqu’à 1,3 PFLOPS de puissance de calcul en précision FP8, avec une prise en charge native du format émergent FP4 jusqu’au FP64 pour les calculs scientifiques de haute précision. Le tour de force réside dans l’enveloppe thermique contenue à 350 Watts seulement.
Contrairement aux monstres thermiques concurrents dépassant régulièrement 600 à 1 000 Watts, le GPU D270 adopte un format carte fille PCIe 5.0 x16 standard à refroidissement purement passif par air. Nul besoin de moderniser les baies serveurs avec des circuits d’eau complexes : la carte s’insère directement dans l’infrastructure de datacenter déjà établie.
À titre de comparaison, une carte comme la Nvidia RTX PRO 5500 sous architecture Blackwell culmine à 846 TFLOPS FP8 pour une enveloppe de 600 Watts. Intel parvient ainsi à dépasser ce débit matriciel tout en réduisant la consommation de près de 42 %.
Le pari de la mémoire LPDDR5X : jusqu’à 480 Go sans le surcoût de la HBM
L’innovation la plus stratégique de Crescent Island réside dans son sous-système mémoire. Alors que Nvidia et AMD se livrent une guerre fratricide sur la mémoire HBM3e et HBM4 (sujette à de graves pénuries d’approvisionnement et des coûts d’assemblage prohibitifs), Intel a fait le choix audacieux d’intégrer de la LPDDR5X haute densité.
La carte de référence PCIe signée Intel propose 160 Go de mémoire LPDDR5X, tandis que les constructeurs partenaires ODM bénéficient de la liberté technique d’assembler des modèles montant jusqu’à 480 Go de capacité mémoire avec une bande passante atteignant 1,5 To/s.
Cette capacité gigantesque change la donne pour le traitement des contextes longs et des caches clé-valeur (KV Cache). Une seule carte D270 peut héberger et exécuter en local des modèles géants de 300 milliards de paramètres, là où il fallait auparavant immobiliser plusieurs accélérateurs couplés en réseau.
Agents IA autonomes et écosystème logiciel ouvert
Intel cible très clairement le marché de l’inférence par lots et des agents autonomes multi-tâches. Un cluster rack standard équipé de 8 cartes D270 est capable de faire tourner des modèles dépassant les 1 000 milliards de paramètres (1 Trillion) sans subir de saturation mémoire.
Sur le front applicatif, le fondeur évite le piège du propriétaire en misant sur l’interopérabilité. La gamme D-Series s’intègre nativement aux frameworks standards du marché comme vLLM, SGLang, Triton, oneDNN, OpenVINO et PyTorch, ainsi qu’aux environnements d’orchestration hétérogènes capables de coopérer avec des infrastructures Nvidia Dynamo ou l’architecture de calcul IA Zen 6 Helion d’AMD.
Un positionnement chirurgical face au quasi-monopole de Nvidia
L’échantillonnage auprès des partenaires industriels débutera au cours du second semestre 2026. En s’écartant de la course effrénée aux bandes passantes démesurées de la HBM pour privilégier la densité mémoire brute de la LPDDR5X, Intel répond au véritable gouffre financier des fournisseurs de services d’IA.
Pour les opérateurs de cloud et les entreprises qui déploient des modèles massifs à grande échelle, l’enjeu ne réside plus seulement dans la vitesse pure d’entraînement, mais dans la capacité à servir des millions de tokens par seconde sans faire disjoncter les baies de serveurs.
Mon avis : le réveil d’Intel qu’on n’attendait plus dans la course à l’IA
On en parlait encore il y a peu de temps à la rédaction : entre l’hégémonie écrasante de Nvidia et la montée en puissance d’AMD sur les serveurs, beaucoup avaient déjà rayé Intel de la carte en estimant qu’Intel avait définitivement raté le train de l’intelligence artificielle.
L’arrivée de cette nouvelle carte IA signée Intel prouve exactement le contraire. Plutôt que de foncer tête baissée dans le mur de la HBM hors de prix pour tenter d’égaler les monstres énergivores de Jensen Huang, Intel choisit une esquive technique brillante.
En misant sur 480 Go de LPDDR5X et une carte PCIe passive de 350 Watts qui s’enfiche directement dans les baies de serveurs existantes, la firme de Santa Clara rappelle qu’elle a encore de sacrés cerveaux dans ses labos. Voir Intel refaire surface et s’inviter dans la mêlée aux côtés d’AMD face au quasi-monopole de Nvidia, c’est la meilleure nouvelle possible pour éviter un marché de l’IA totalement verrouillé par un seul constructeur.
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Consultant SEO depuis plus de 20 ans et entrepreneur du web, Charles 'Grimtag' Ronchain est le fondateur de Pro-Gamer.fr, Retrocharting.com et Gamescharting.com. Ancien joueur hardcore, streamer et collectionneur de jeux vidéo, il baigne dans l'industrie vidéoludique depuis plus de 15 ans, notamment comme consultant pour les plus grands comparateurs de prix de jeux vidéo. Passionné par la data, l'IA et les opportunités du numérique, il décrypte sur Pro-Gamer.fr les métiers du jeu vidéo, la monétisation (streaming, e-sport, création de contenu) et le matériel gaming avec un regard d'expert de terrain.