Linux 7.5 purge les dernières optimisations Intel MMX de 1997 : 800 lignes d’assembleur Pentium remplacées par 12 lignes de code
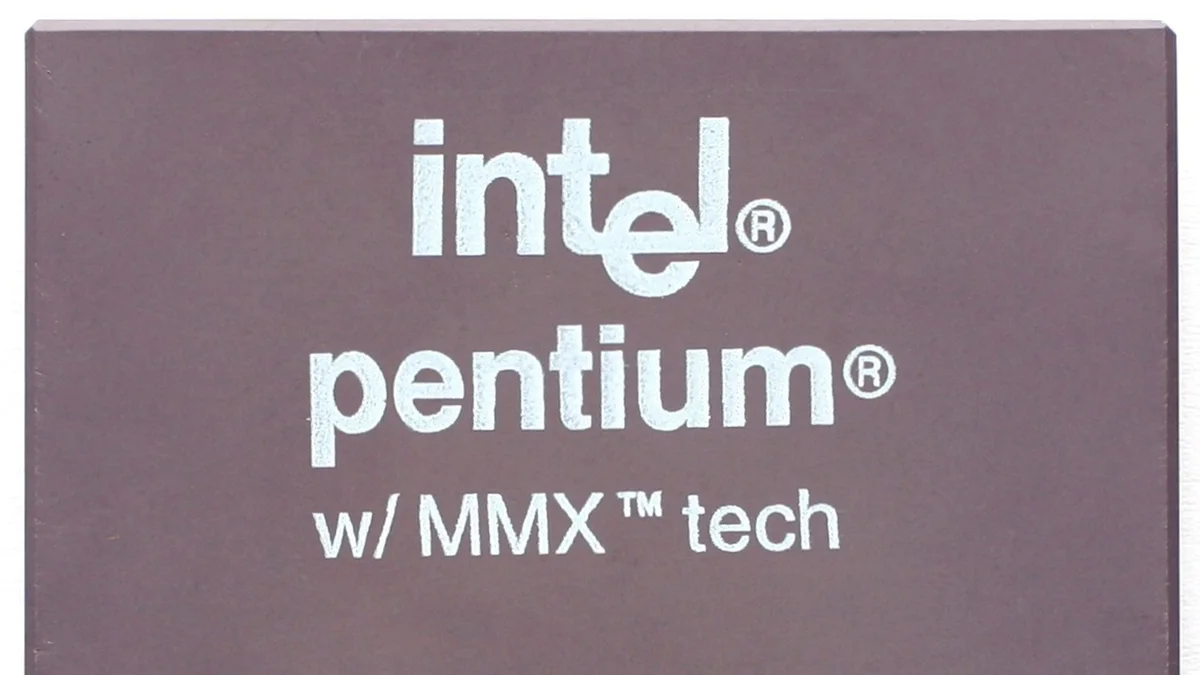
Trente ans après l’arrivée en fanfare des processeurs Intel Pentium MMX en janvier 1997, le noyau open source Linux 7.5 (attendu début 2027) s’apprête à tourner définitivement la page de la toute première extension vectorielle de l’architecture x86. Par le biais d’une série de trois correctifs soumise par l’ingénieur Eric Biggers (Google) au sein de la branche mm-everything maintenue par Andrew Morton sur le dépôt Git officiel du noyau Linux (kernel.org), les toutes dernières routines assembleur MMX encore présentes dans le système d’exploitation sont supprimées.
Le dernier bastion du RAID logiciel : plus de 800 lignes d’assembleur remplacées par 12 lignes
Contrairement à une idée reçue, les fonctions mémoire les plus sollicitées du noyau Linux (telles que memcpy(), copy_page() et clear_page()) avaient déjà abandonné leurs optimisations MMX et 3DNow! dès 2021 via le commit c6dbd3e5e69c. De même, ni le sous-système cryptographique ni les calculs d’intégrité CRC ne faisaient plus appel à ces instructions héritées de l’ère 32 bits. Dans l’intégralité de l’arborescence du noyau, une seule enclave isolée résistait encore : le moteur de calcul de parité XOR et RAID6 du RAID logiciel.
Concrètement, les fichiers d’en-tête 32 bits du sous-système x86 conservaient des routines assembleur écrites à la main pour les architectures Pentium P55C et Pentium II afin d’accélérer les opérations logiques XOR sur les grappes de disques RAID dépourvues du jeu d’instructions SSE. En nettoyant cette anomalie historique ainsi que la détection CPU dans le code RAID6, la série de correctifs d’Eric Biggers retranche plus de 800 lignes de code assembleur pour les remplacer par seulement 12 lignes de code. Ce ménage de printemps s’inscrit dans la même philosophie de rigueur que la maintenance de sécurité du noyau Linux et de SteamOS face aux vulnérabilités critiques, où l’élimination des branches de code obsolètes réduit mécaniquement la dette technique.
Point essentiel pour les amateurs de rétro-informatique : cette suppression ne casse aucunement la compatibilité matérielle. Si un passionné démarre un noyau Linux 7.5 sur un véritable Intel Pentium MMX de 1997, un Pentium II ou un AMD K6 configuré avec une grappe RAID logicielle, la machine démarrera et fonctionnera sans la moindre erreur. Le noyau basculera simplement sur les routines scalaires standard écrites en langage C (scalar C fallbacks), déjà éprouvées et activement maintenues.
Pourquoi le MMX de 1997 partageait les registres x87 FPU : retour sur un compromis architectural
Pour comprendre pourquoi les développeurs du noyau Linux souhaitaient se débarrasser de ces dernières routines MMX, il faut revenir au compromis matériel conçu par Intel lors du lancement du Pentium P55C en janvier 1997. Gravée en 350 nanomètres avec 4,5 millions de transistors et dotée d’un cache L1 doublé à 32 Ko (16 Ko pour les instructions et 16 Ko pour les données), cette puce inaugurait 57 nouvelles instructions SIMD (Single Instruction, Multiple Data) capables de traiter des vecteurs d’entiers de 64 bits (huit octets, quatre mots de 16 bits ou deux double-mots de 32 bits en une seule opération).
Afin que Windows 95, OS/2 ou les noyaux Linux de l’époque puissent exécuter du code MMX immédiatement sans modifier leur gestionnaire de changement de contexte (context switch), les ingénieurs d’Intel ont pris une décision radicale : au lieu de créer de nouveaux registres physiques indépendants, ils ont plaqué les huit registres MMX de 64 bits (MM0 à MM7) directement en alias sur la mantisse de 64 bits des huit registres de pile de l’unité à virgule flottante x87 FPU (ST(0) à ST(7)).
Ce partage physique interdisait d’exécuter simultanément des calculs flottants x87 et des opérations vectorielles MMX. Après chaque séquence MMX, le processeur devait impérativement appeler l’instruction EMMS (Empty MMX State) pour réinitialiser l’état des registres FPU, une opération coûteuse qui pénalisait lourdement le pipeline. Au sein du noyau Linux, mobiliser les registres MMX pour calculer une parité RAID obligeait en outre à sauvegarder et restaurer l’état FPU matériel. Pour l’anecdote, alors que les campagnes publicitaires de 1997 vantaient des MultiMedia eXtensions, Intel avait soutenu devant les tribunaux que le sigle « MMX » ne signifiait rien afin d’en protéger la marque, avant qu’un procès contre AMD ne révèle l’appellation interne Matrix Math Extensions dans des archives qui rappellent l’histoire mouvementée du kit de développement GPU Intel Larrabee récemment retrouvé.
Tableau comparatif : 30 ans d’évolution des instructions vectorielles SIMD x86
| Jeu d’instructions | Année | Largeur des vecteurs | Architecture des registres | Processeurs emblématiques |
|---|---|---|---|---|
| Intel MMX | Janvier 1997 | 64 bits (entiers uniquement) | 8 registres (MM0 à MM7) partagés avec la pile x87 FPU | Intel Pentium MMX (P55C), Pentium II, AMD K6, Cyrix 6x86MX |
| AMD 3DNow! | Mai 1998 | 64 bits (flottants 32 bits) | 8 registres (MM0 à MM7) partagés avec la pile x87 FPU | AMD K6-2, K6-III, Athlon K7 |
| SSE / SSE2 | 1999 / 2000 | 128 bits (flottants 32/64 bits et entiers) | 8 puis 16 registres dédiés indépendants (XMM0 à XMM15) | Intel Pentium III (SSE), Pentium 4, AMD Athlon 64 (SSE2) |
| AVX / AVX2 | 2011 / 2013 | 256 bits (flottants, entiers et FMA) | 16 registres dédiés (YMM0 à YMM15) | Intel Sandy Bridge, Haswell, Core Ultra, AMD Zen à Zen 3 |
| AVX-512 / AVX10 | 2017 / 2026 | 512 bits (RAID XOR, cryptographie et IA) | 32 registres dédiés (ZMM0 à ZMM31) + registres de masquage | Intel Xeon, AMD Ryzen 7000 (Zen 4) et Ryzen 9000 (Zen 5) |
Sur les machines actuelles, le contraste est saisissant : tandis que MMX manipulait 8 octets à la fois sur des registres empruntés au coprocesseur arithmétique, les processeurs modernes dotés d’unités AVX-512 natives en 512 bits (comme l’architecture Zen 5 de l’AMD Ryzen 7 9800X3D) traitent 64 octets par instruction en un seul cycle d’horloge, précisément là où Eric Biggers concentre désormais les optimisations XOR et cryptographiques du noyau Linux.
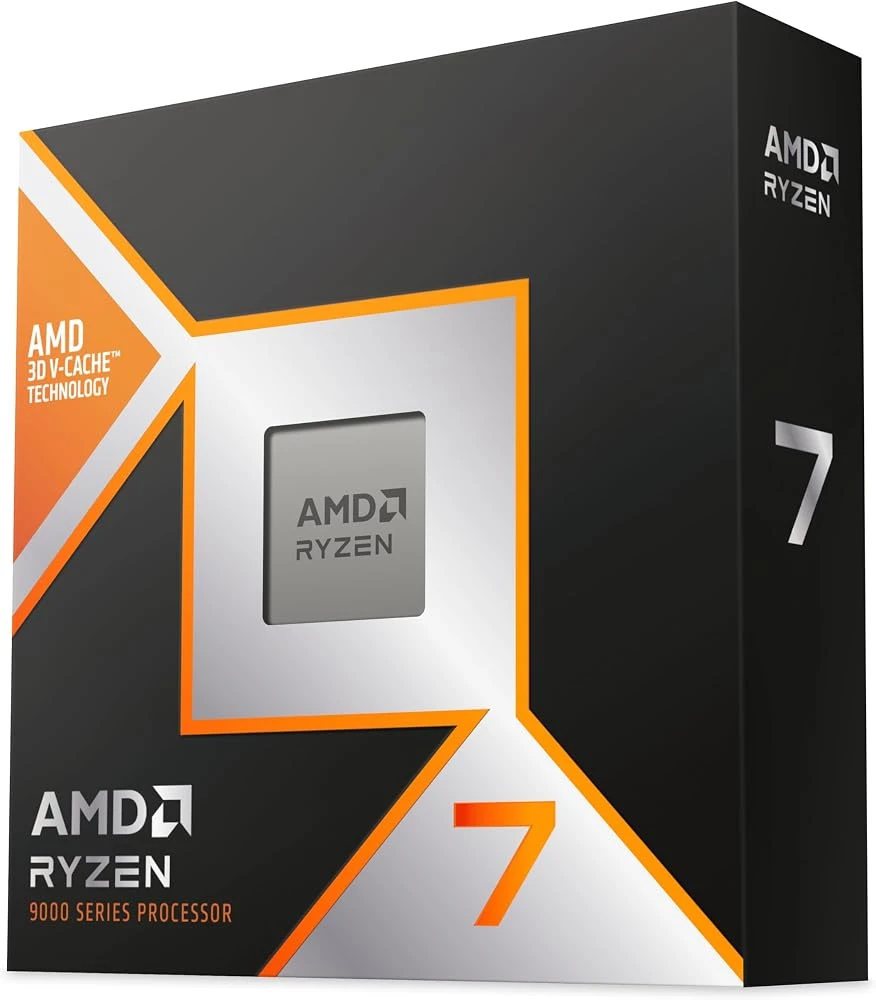
AMD Ryzen 7 9800X3D (8 cœurs / 16 threads, 5,2 GHz, Socket AM5)
- 8 cœurs / 16 threads Zen 5 avec exécution AVX-512 native 512 bits en 1 cycle
- 96 Mo de cache L3 3D V-Cache de 2e génération (104 Mo L2+L3 cumulés)
- Fréquence Boost jusqu'à 5,2 GHz sur plateforme Socket AM5 DDR5 et PCIe 5.0
Voir les disponibilités AMD Ryzen 7 9800X3D sur Amazon→
Mon regard
Quand j'échange avec Bastien « Orion » dans notre labo sur nos premiers montages de tours beiges AT en 1997, le macaron métallisé Intel Inside Pentium MMX évoque immédiatement une époque charnière du jeu sur PC. Passer d'un Pentium 133 classique à un Pentium MMX cadencé à 166 ou 200 MHz promettait alors de transformer la fluidité du décodage vidéo MPEG-1, du mixage sonore et surtout des vitrines technologiques taillées pour ces 57 instructions inédites, à commencer par POD : Planet of Death d'Ubisoft ou les exécutables optimisés de Quake.
Qu'un fragment de cet assembleur MMX 64 bits ait survécu pendant près de trois décennies au cœur du sous-système RAID de Linux témoigne de l'incroyable mémoire géologique du logiciel libre. Mais du point de vue de l'ingénierie système, remplacer plus de 800 lignes d'assembleur inféodées aux registres x87 par 12 lignes propres tout en conservant le repli en langage C scalaire est la décision la plus élégante possible : un Pentium MMX d'époque continuera de démarrer sous Linux 7.5 en 2027, et les mainteneurs du noyau ferment avec les honneurs un chapitre fondateur de l'architecture PC.
Retrouvez Pro-Gamer en priorité sur Google
Ajoutez pro-gamer.fr à vos sources préférées pour retrouver nos guides et actus directement dans votre flux Google Discover et vos résultats de recherche.
Américaine installée dans la périphérie de New York, Chaya « Chayane » a passé 5 ans à Montréal pour ses études d'ingénierie logicielle avant de revenir dans sa région natale. Développeuse Full-Stack et chercheuse en architectures de Deep Learning et d'IA, elle explore les réseaux neuronaux et l'optimisation algorithmique tout en concevant les outils de Retrocharting et Gamescharting aux côtés de Grimtag. Gamer depuis plus de 20 ans, collectionneuse passionnée de l'univers Nintendo et de la saga The Legend of Zelda, elle a arpenté Azeroth sur World of Warcraft avant de mettre son expertise technique au service de l'analyse vidéoludique.